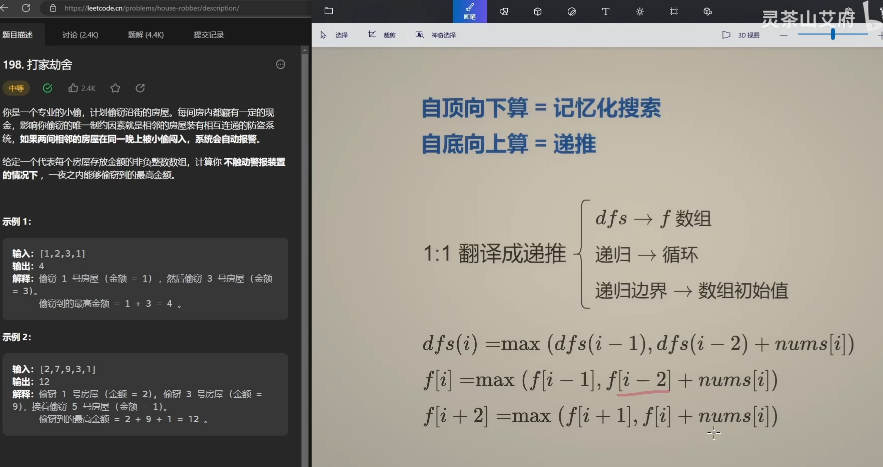
动态规划原理 DP Principle
核心:状态定义和状态转移
自顶向下:记忆化搜索,即递归
自底向上:递推,即递推
01 198. 打家劫舍 / House Robber
简要题意: 房屋沿直线排列,第 i 间存有 nums[i] 金额。不能同时选择相邻房屋,返回可获得的最大金额。可以不选择任何房屋。
递归思路(自顶向下)
- 大白话:
- 自顶向下,从n开始,可以选择打劫或不打劫,自然其打劫的金额是不同的。选择打劫,则需要跳过n-1的房子的钱
- 公式
- dfs(i) = max(dfs(i-1), dfs(i-2)+nums[i])
- 记忆化搜索
- 由于dfs(n)需要知道dfs(n-1)和dfs(n-2),而dfs(n-1)需要知道dfs(n-2)和dfs(n-3)
- 可以发现他们都需要dfs(n-2),我们可以用一个cache数组把他们记忆住
- 时间复杂度:O(n)
- 空间复杂度:O(n)
- 完成状态定义、转移和边界后,再实现代码。
class Solution:
    def rob(self, nums: List[int]) -> int:
        n = len(nums)
        if n <= 0:
            return 0
        if n <= 2:
            return max(nums)
        @cache
        def dfs(i):
            if i < 0:
                return 0
            if i == 0:
                return nums[i]
            return max(dfs(i-1), dfs(i-2)+nums[i])
        return dfs(n-1)
递归(手动记忆化搜索)
class Solution:
    def rob(self, nums: List[int]) -> int:
        n = len(nums)
        if n <= 0:
            return 0
        if n <= 2:
            return max(nums)

        cache = [-1] * n
        def dfs(i):
            if i < 0:
                return 0
            if i == 0:
                return nums[i]
            if cache[i] != -1:
                return cache[i]
            cache[i] = max(dfs(i-1), dfs(i-2)+nums[i])
            return cache[i]
        return dfs(n-1)
递推思路(自底向上)
f[n]=max(f[n-1], f[n-2]+val[n])
class Solution:
    def rob(self, nums: List[int]) -> int:
        n = len(nums)
        if n <= 0:
            return 0
        if n <= 2:
            return max(nums)
        f = [0] * (n+1)
        f[0] = nums[0]
        f[1] = max(nums[1], nums[0])
        for i in range(2, n):
            f[i] = max(f[i-2]+nums[i], f[i-1])
        return f[n-1]
一维数组递推,是从左往右还是从右往左?
配图
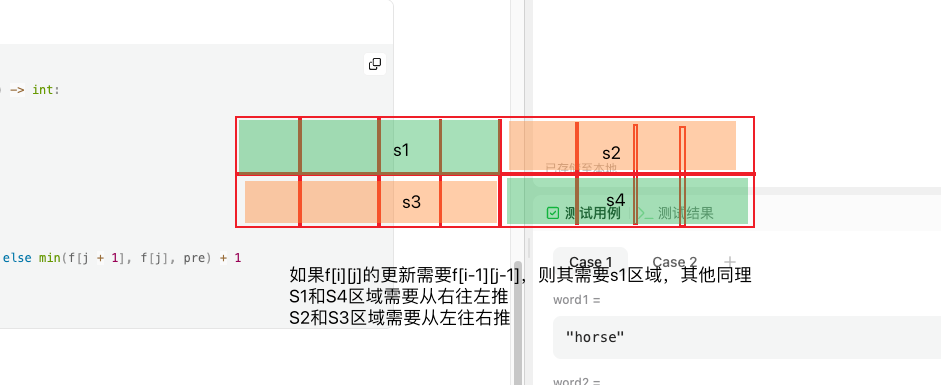
原理
- S1区域是上一轮的数据,从左往右推的时候会被覆盖掉,所以需要从右往左更新当前值
- S2区域是上一轮的数据,同上,避免被覆盖,需要从左往右更新
- S3区域是下一轮的数据,如果当前值需要这里的数据,则需要从左往右更新
- S4区域是下一轮的数据,如果当前值需要这里的数据,则需要从右往左更新